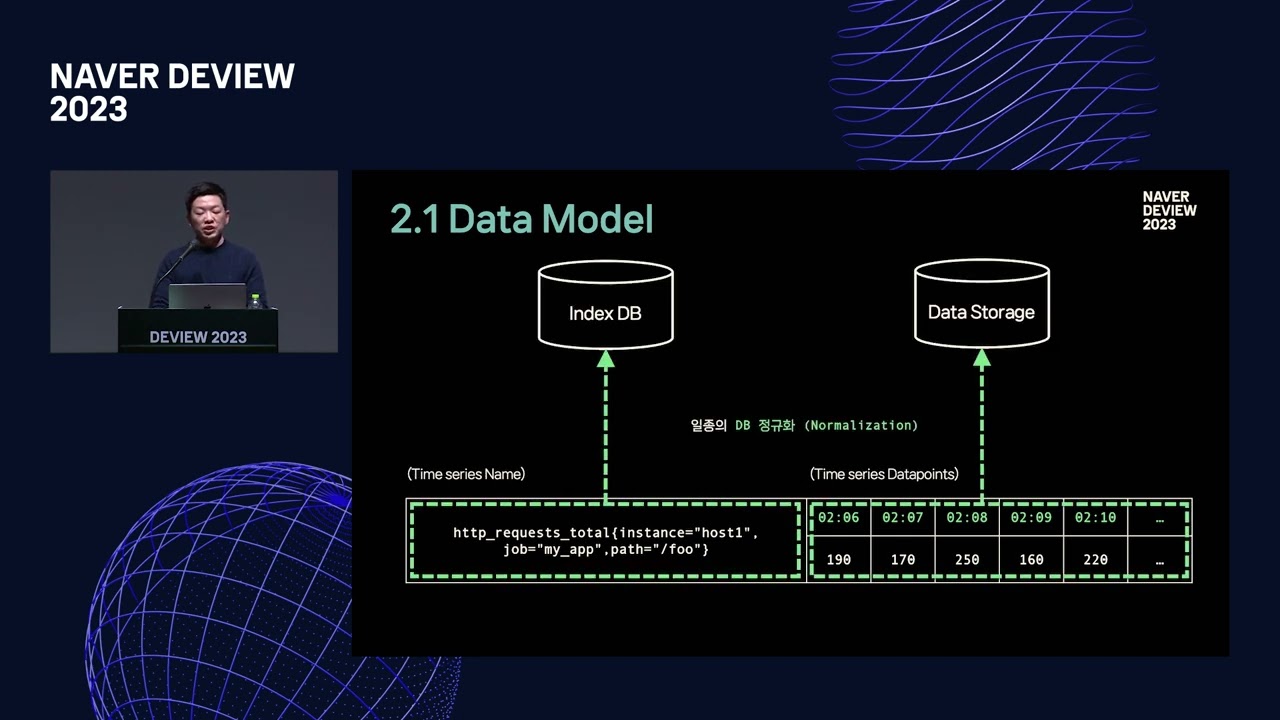
VictoriaMetrics: 시계열 데이터 대혼돈의 멀티버스
DEVIEW 2023 네이버 · YouTube
AI 핵심 요약
네이버 서치의 수만 대 서버와 수많은 서비스를 모니터링하면서 시계열 규모가 커지자, VictoriaMetrics의 내부 구조와 2년간의 운영 경험을 공유했다. VictoriaMetrics는 LSM 트리 기반 인덱스·데이터 저장소와 고릴라 압축으로 대량의 시계열을 처리하며, 단일 노드의 장애 위험과 서로 다른 조회 패턴의 과부하를 해결하기 위해 클러스터 모드와 용도별 클러스터 분리를 적용했다. 데이터 유실을 줄이도록 메시지 큐와 vmagent 버퍼링을 두고, 무거운 대시보드 조회는 사전 계산한 시계열로 대체했으며, 고가용성을 위해 멀티 레벨 클러스터도 활용했다. 대규모 시계열 운영에서는 제품 선택만으로 충분하지 않고, 카디널리티와 읽기·쓰기 부하를 고려한 격리·버퍼링·마이그레이션 설계가 필요하다는 점을 강조했다.
- LSM 트리는 쓰기를 메모리에서 정렬한 뒤 파일로 플러시하고 백그라운드에서 병합해 읽기·쓰기 성능을 높인다.
- 고릴라 압축은 일정한 수집 간격과 값의 유사성을 활용해 시계열 데이터의 저장 공간을 줄인다.
- 레이블 값이 자주 바뀌면 하이 카디널리티가 발생해 인덱스와 저장소 부하가 커지므로, 불필요한 레이블을 제거하거나 변환한다.
- 대시보드와 알람 시스템의 조회 패턴이 다르면 클러스터를 분리해 서로의 부하가 전파되지 않도록 한다.
- 쓰기 유실에는 메시지 큐와 vmagent 버퍼링을, 무거운 조회에는 사전 계산한 시계열을 활용할 수 있다.
소개
[DEVIEW 2023] * 발표자 : 손주식, 이선규(NAVER Search) * 발표제목 : VictoriaMetrics: 시계열 데이터 대혼돈의 멀티버스 * DEVIEW 2023 바로가기: https://deview.kr/2023 #DEVIEW #DEVIEW2023 #데뷰 #데뷰2023
비슷한 학습 자료

컨퍼런스 DEVIEW 2023
CQuery : 우당탕탕 Trino와 썸타기

컨퍼런스 DEVIEW 2023
싸늘하다, 메신저에 경보가 날아와 꽂힌다 - 네이버 검색 SRE 시스템 개선기
컨퍼런스 DEVIEW 2023
NSML: 대규모 HPC 클러스터의 효율적 활용을 위한 Scheduler, Monitoring, Diagnostics
컨퍼런스 DEVIEW 2023
AiSuite: 안정적으로 멀티 테넌트 AI 플랫폼 제공하기

컨퍼런스 DEVIEW 2023
SCDF로 하루 N만곡 이상 VIBE 메타 데이터 실시간으로 적재하기!

컨퍼런스 엔지니어링데이 2025
Iceberg Low-Latency Queries with Materialized Views (feat. 실시간 거래 리포트)
컨퍼런스 엔지니어링데이 2025
네이버 사내 기술 교류 행사인 NAVER ENGINEERING DAY 2025 에서 발표되었던 세션을 공개합니다. [발표 내용] - 본 영상에서는 “실시간 거래 리포트를 어떻게 하면 사용자가 원하는 다양한 조건으로 빠르게 조회할 수 있을까?” 라는 질문에서 출발한 기술적 여정을 다룹니다. - 단순히 데이터를 쌓고 조회하는 단계를 넘어, 거래 데이터의 최신성과 응답 속도, 그리고 확장성을 동시에 확보하기 위한 여러 시도를 공유합니다. [발표 대상] - 데이터 플랫폼 엔지니어 / 데이터 아키텍트 – 대용량 실시간 데이터 처리 및 저지연 설계에 관심 있는 분 - 분석 플랫폼 운영자 / BI 개발자 – 다차원 필터 조회 속도 및 Freshness 향상 전략을 찾고 있는 분 - Spark, Iceberg, StarRocks 활용자 – 실제 조합 운영 사례를 통해 운영 팁을 얻고자 하는 분 [목차] 0. 소개 (Introduction) 1. 문제 정의 (Problem Definition)...
데이터베이스 데브옵스 · 인프라