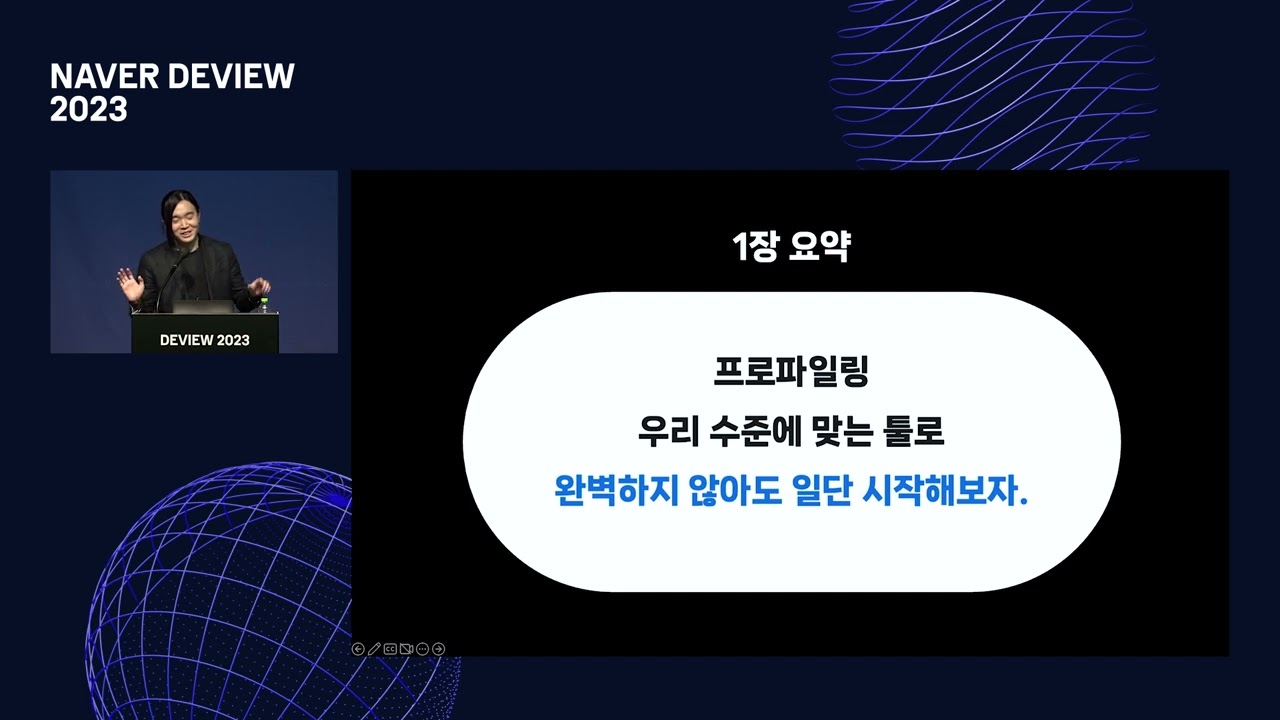
ML/AI 개발자를 위한 단계별 Python 최적화 가이드라인
DEVIEW 2023 네이버 · YouTube
AI 핵심 요약
이미지 번역 서비스에서는 여러 AI 모델의 전후처리와 렌더링이 Python으로 이뤄져 GPU보다 CPU가 병목이 되는 경우가 있었다. 발표자는 `line_profiler`로 코드 라인별 소요 시간을 확인한 뒤 NumPy 연산과 비트 연산을 활용해 같은 결과를 더 효율적으로 내도록 고쳤다. 순수 Python 병목에는 Cython·Numba를, 외부 패키지 처리까지 더 빠르게 해야 하는 경우에는 Python C API로 C++ 코드를 연결하고 OpenMP 병렬화를 적용하는 단계적 접근을 소개했다. 프로파일링과 최적화를 반복해 예시 처리 시간을 크게 줄였으며, 실제 서비스에서도 레이턴시를 낮춘 경험을 공유했다.
- 라인 프로파일러를 적용해 함수별 추측이 아니라 실제 병목 라인을 기준으로 최적화하세요.
- 병목이 외부 패키지 호출이라면 같은 결과를 내는 NumPy 연산이나 비트 연산 등 더 효율적인 표현이 있는지 비교하세요.
- Cython이나 Numba는 병목 구간이 순수 Python으로 구현됐거나 직접 옮길 수 있을 때 우선 검토하세요.
- 외부 패키지의 처리 자체가 병목이면 Python C API로 C/C++에 연결하고, OpenMP 같은 도구로 병렬화를 고려할 수 있습니다.
- 최적화 후에는 다시 프로파일링하고, 성능 향상과 코드 복잡도 사이의 균형을 확인하세요.
소개
[DEVIEW 2023] * 발표자 :문주혁(NAVER Cloud) * 발표제목 : ML/AI 개발자를 위한 단계별 Python 최적화 가이드라인 * DEVIEW 2023 바로가기: https://deview.kr/2023 #DEVIEW #DEVIEW2023 #데뷰 #데뷰2023
비슷한 학습 자료

컨퍼런스 if kakao
if(kakao)25 GPU 도입부터 LLMOps 구축, 그리고 이를 기반으로 LLM을 활용한 AI 에이전트 및 워크플로우 개발을 위한 플랫폼 개발 과정을 소개합니다. #TECH #AI #LLM 카카오페이에서 DevOps 업무를 담당하고 있는 유수지(stella.yu)입니다. 카카오페이에서 서버개발을 담당하고 있는 최원호(wayne.cai)입니다. AI Native 업무에 관심이 많습니다. 발표자료 보기 📍https://if.kakao.com/2025/session?sessionId=42 📍if.kakao.com if(kakao)25 홈페이지 : https://if.kakao.com/2025 #카카오 #kakao #이프카카오25
데브옵스 · 인프라 AI에이전트 개발

컨퍼런스 if kakao
Preview AI_1 @if(kakao)2021
컨퍼런스 if kakao
if (kakao) 2021 컨퍼런스에서 AI 관련 기술 발표 세션을 소개합니다. 1. TensorFlow Serving보다 10배 빠르게 서빙하기 @jesse.ha 텐서플로우로 만든 딥러닝 모델을 서비스에서 사용하기 위해 인퍼런스 서버를 구축하는 과정에서 코드 레벨/도메인 레벨/Layer Fusion/구현 레벨 등 다양한 관점에서의 최적화를 통해 TensorFlow Serving보다 10배 빠르게 만든 과정을 공유합니다. 2. ML로 기프트권 받을 유저 정하기 @yul.kk ML을 사용하여 픽코마 무료 에피소드 열람 기프트권 발송을 효율적으로 해결한 방법에 대해 설명합니다. Feature 생성 및 선정과 실서비스 적용 시 주의했던 점들을 공유합니다. 3. BERT보다 10배 빠른 BERT 모델 구축 @marko.k BERT는 NLP 분야에서 SOTA 모델이지만 학습하는데 많은 시간과 컴퓨팅 리소스가 필요합니다. 기존 BERT 대비 10배 더 빠르게 학습시키고 성능도 더 좋...
딥러닝 · 머신러닝 자연어 처리

컨퍼런스 DEVIEW 2023
이제는 AI가 읽고(Language), 보고(Vision), 생성하는 Large-scale Multimodal의 시대입니다
컨퍼런스 DEVIEW 2023
NSML: 대규모 HPC 클러스터의 효율적 활용을 위한 Scheduler, Monitoring, Diagnostics
컨퍼런스 엔지니어링데이 2025
레거시 GPU에 날개 달기: 극한의 서빙 최적화 가이드
컨퍼런스 엔지니어링데이 2025
네이버 사내 기술 교류 행사인 NAVER ENGINEERING DAY 2025(5월)에서 발표되었던 세션을 공개합니다. [발표 내용] 이 세션에서는 BERT기반 모델인 SPLADE모델의 대규모 실시간 서비스를 위한 최적화 방법에 대해서 이야기 합니다. 세상에서 가장 빠른 BertTokenizer 구현체인 FlashTokenizer 의 개발 배경과 성능에 대해 소개합니다. [강의 대상] 실시간 서빙을 위한 모델 추론 최적화가 필요하신 분들 [목차] - Introduction - Model Simplify - Inference Optimization(basic) - Postprocess Optimization - Preprocess Optimization - Inference Optimization(advanced) - Service
데브옵스 · 인프라 자연어 처리

컨퍼런스 엔지니어링데이 2025
AI 경량화: 더 빠르고 저렴한 AI 서비스 - 백동원_NE DAY 23. 10
컨퍼런스 엔지니어링데이 2025
네이버 사내 기술 교류 행사인 NAVER ENGINEERING DAY(10월)에서 발표되었던 세션을 공개합니다. ----- [발표 내용] * AI 경량화 삽질기 (feat. LaRva) - Quantization과 삽질기 - Pruning과 삽질기 - Low-Rank와 삽질기 - Knowledge Distillation과 삽질기 * AI 경량화 Benefits & Risks - 전력 소모 단위에서의 AI 경량화 - 각종 논문에서의 AI 경량화 안정성 반증 - AI 경량화에서 얻을 수 있는 Benefits - AI 경량화를 할 때 대비해야 하는 Risks
딥러닝 · 머신러닝