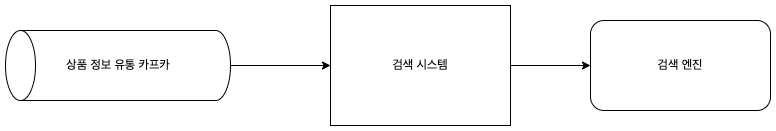
컬리 검색이 카프카를 들여다본 이야기 1
서민우 컬리 · 컬리 기술 블로그
AI 핵심 요약
검색 색인에 여러 토픽의 상품 정보를 조합하도록 구조를 바꾼 뒤, 컨슈머 처리 속도가 발행 속도를 따라가지 못하고 예기치 않은 리밸런싱까지 발생했다. Redis 지표에서 과부하 징후를 찾지 못한 뒤 Kafka 설정을 살펴보고, `max-poll-records`를 1로 낮춰 리밸런싱을 우선 억제했다. 이어 Spring Kafka의 Record Listener를 Batch Listener로 바꾸고, 여러 레코드를 모아 검색 엔진에 배치 색인 요청을 보내 처리 스루풋을 높였다. 배치 처리로 메시지 처리 시간이 줄어 기존 레코드 수와 시간 설정에서도 리밸런싱이 발생하지 않았으며, 설정 조정과 처리 방식 개선을 함께 검토해야 한다는 점을 확인했다.
- 메시지 처리 시간이 `max.poll.interval`을 넘으면 컨슈머 그룹 리밸런싱이 발생할 수 있으므로, 처리 시간과 poll 설정을 함께 점검한다.
- `max-poll-records`를 줄이면 한 번에 처리할 부담을 낮춰 리밸런싱을 완화할 수 있지만, 처리량 개선의 근본 해법은 아니다.
- Spring Kafka의 Batch Listener는 poll로 가져온 레코드를 묶어 처리하므로, 배치 색인을 지원하는 검색 엔진과 함께 쓰면 요청 오버헤드를 줄일 수 있다.
- 처리 지연이 생겼을 때는 Redis 등 주변 컴포넌트의 지표를 확인해 병목이 실제로 어디에 있는지 좁혀간다.
소개
카프카 설정 튜닝만으로 색인 속도를 개선하다
비슷한 학습 자료
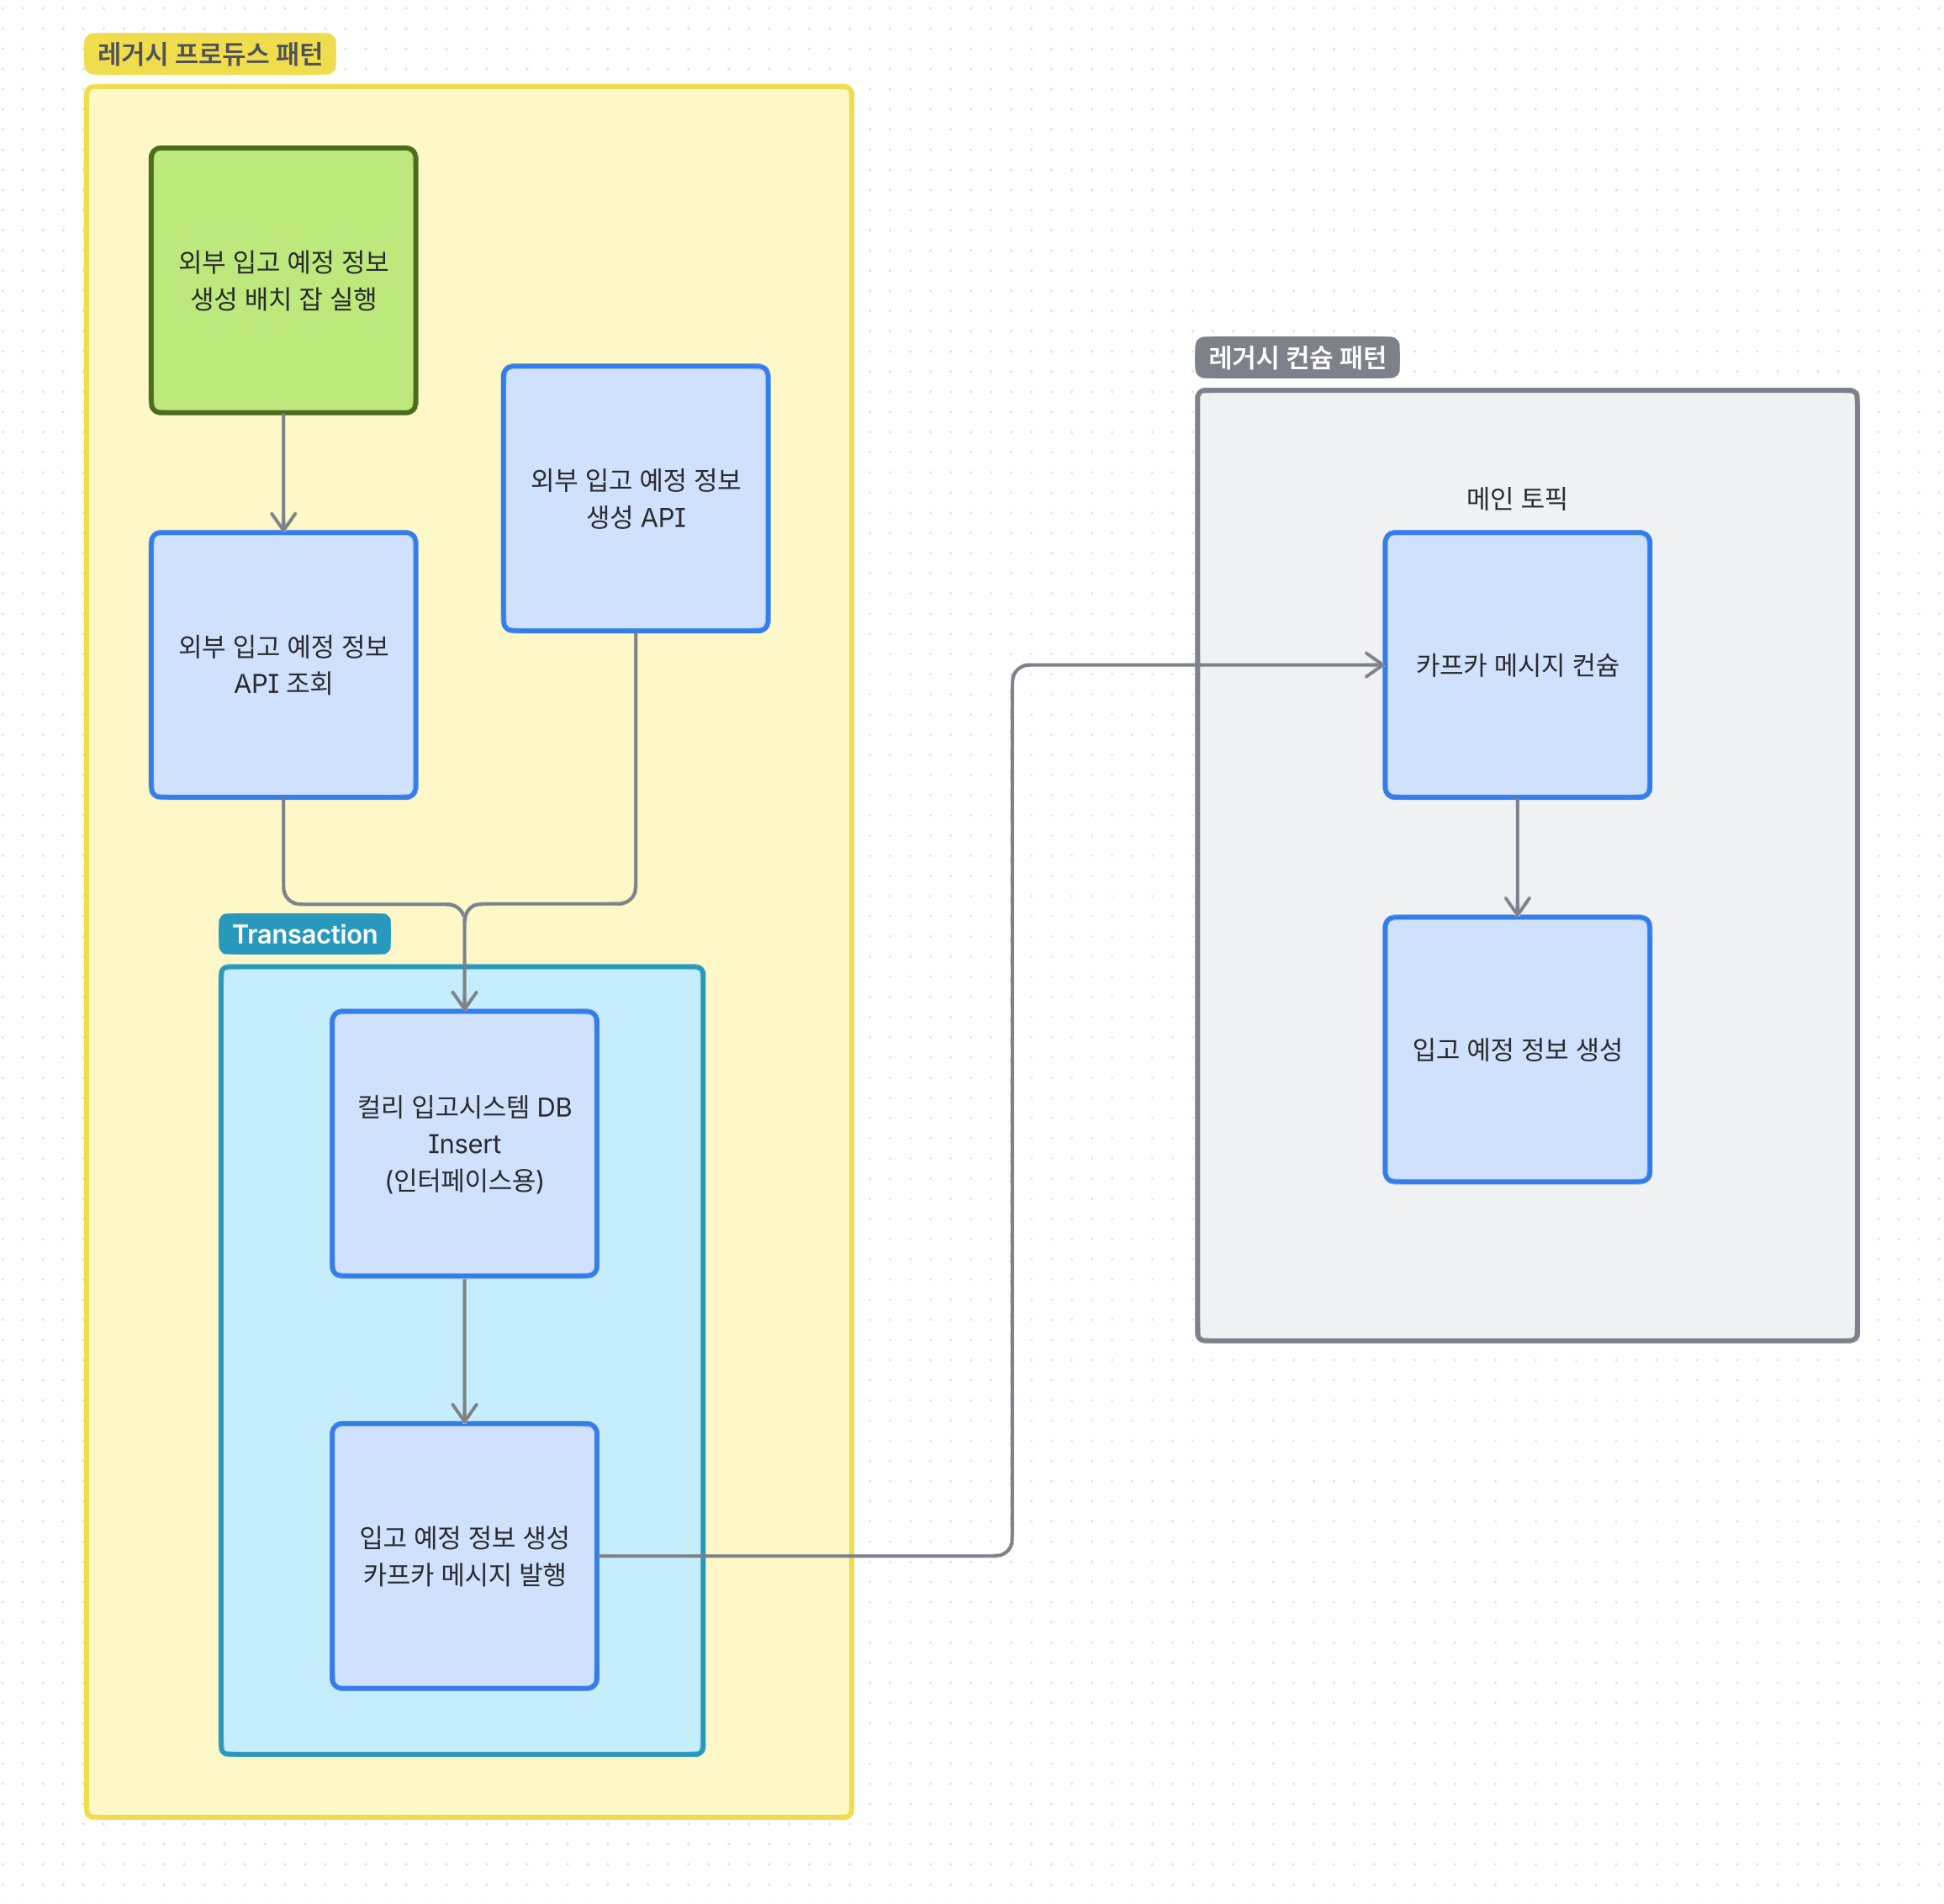
문서 서민우
컬리 검색이 카프카를 들여다본 이야기 2
문서 박수형
컬리의 Virtual 물류 센터
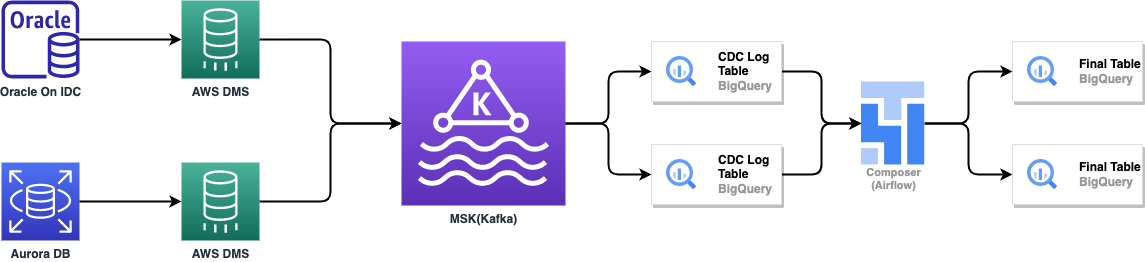
문서 허재진
컬리의 BigQuery 도입기 - 2부
문서 허재진
컬리의 BigQuery 도입기 - 1부
문서 이민식